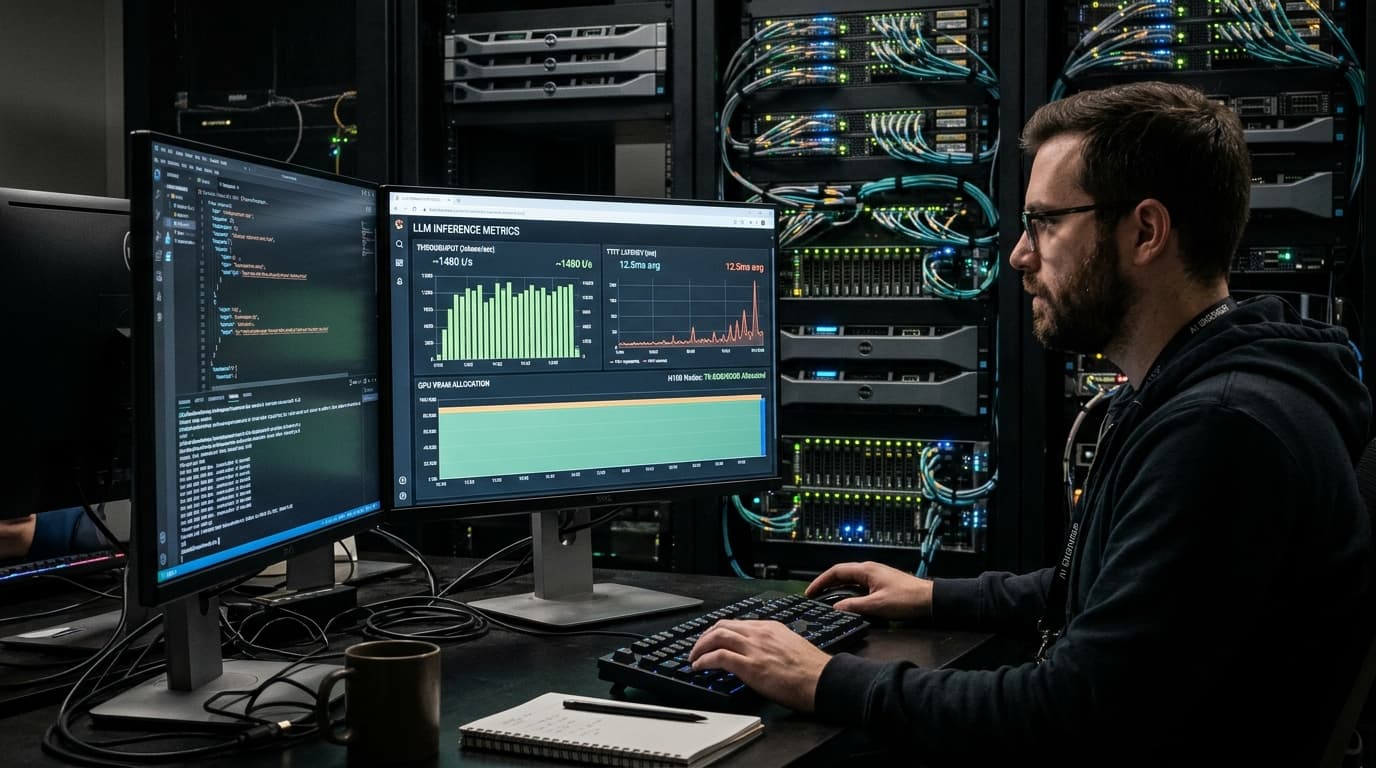
Colocar um modelo de linguagem em produção deixou de ser um problema de precisão matemática para se tornar uma batalha brutal de alocação de memória e custo de infraestrutura. Enquanto o treinamento de modelos de fronteira captura as manchetes com orçamentos de centenas de milhões de dólares, o gargalo econômico real dos times de engenharia está na outra ponta: manter instâncias de GPU respondendo requisições com baixa latência e alto throughput sem estourar o orçamento da nuvem. A consolidação de arquiteturas como o vLLM, impulsionadas pelo gerenciamento de memória do PagedAttention, em conjunto com a migração para formatos de quantização em 4 bits (FP4 e NVFP4), está provocando uma redução drástica no custo por milhão de tokens gerados, tornando viável a operação de modelos de centenas de bilhões de parâmetros em clusters substancialmente menores.
📌 Destaques da Notícia
Fim do Desperdício de VRAM: O algoritmo PagedAttention elimina até 80% da fragmentação de memória no cache de chaves e valores (KV Cache), dobrando a densidade de requisições simultâneas por GPU.
O Salto do FP4: A transição da precisão de 16 bits para representações flutuantes de 4 bits permite hospedar modelos massivos em nós de inferência mais compactos sem perda destrutiva de perplexidade.
A Batalha pelo TTFT: Engenheiros concentram esforços na redução do Time to First Token (TTFT) durante a fase de prefill, combinando kernels otimizados de FlashAttention com paralelismo de tensores.
Impacto no Open Source: Frameworks abertos de serving quebram o monopólio de provedores proprietários de API, permitindo que empresas operem sua própria infraestrutura com margens sustentáveis.
O Pesadelo Invisível do KV Cache em Produção
Qualquer desenvolvedor que já subiu um modelo Transformer bruto em um cluster de produção com bibliotecas padrão de deep learning já se deparou com o mesmo muro: o estouro de memória fora de hora (Out of Memory).
O culpado raramente são os pesos do modelo em si.
Durante a fase de decodificação gerativa, cada novo token produzido precisa calcular atenção sobre todos os tokens anteriores. Para evitar o recálculo redundante a cada passo, o sistema salva esses vetores em uma estrutura temporária chamada Key-Value Cache (KV Cache). O problema é que o comprimento das respostas geradas pelos usuários é imprevisível. Em sistemas legados, o servidor precisava pré-alocar blocos contíguos gigantescos de memória de vídeo para o pior cenário possível de contexto (por exemplo, 8.192 ou 32.768 tokens). O resultado era um desperdício crônico: entre 60% e 80% da cara memória HBM das placas ficava reservada para texto que nunca era digitado.
Woosuk Kwon, pesquisador da UC Berkeley e um dos criadores do projeto vLLM, sintetizou o diagnóstico que motivou a reformulação do ecossistema:
"Na geração de texto para modelos de linguagem, o throughput de serving é severamente limitado pela memória física. Identificamos que gerenciar o cache KV de forma dinâmica através de paginação reduz o desperdício de VRAM a quase zero e multiplica a capacidade de concorrência dos aceleradores sem exigir qualquer alteração na arquitetura original do modelo."
A solução inspirou-se em um dos conceitos mais clássicos da ciência da computação: a memória virtual paginada dos sistemas operacionais. Em vez de exigir blocos contíguos de VRAM, o PagedAttention quebra o KV Cache em páginas fixas não contíguas mapeadas por tabelas de blocos. Se uma requisição precisa de mais espaço, uma nova página é alocada dinamicamente sob demanda. Se a requisição termina, a memória é liberada na hora.
Um alívio imediato para quem paga a fatura dos servidores.
Otimizar a inferência exige compreender que a geração de texto em LLMs opera sob duas dinâmicas computacionais totalmente distintas.
A primeira fase é o Prefill. Quando o usuário envia um prompt longo de 4.000 tokens com instruções e documentos, o modelo processa toda essa sequência de entrada de uma só vez em paralelo. Aqui, a operação é limitada pelo poder de cálculo bruto dos núcleos tensores (compute-bound). O tempo que o sistema leva para processar essa entrada e cuspir o primeiro caractere na tela define a métrica de ouro da experiência do usuário: o Time to First Token (TTFT).
A segunda fase é o Decode. O modelo agora precisa gerar uma única palavra por vez sequencialmente. Para cada novo token de poucos bytes, a GPU precisa ler gigabytes inteiros de pesos do modelo da memória HBM para a memória cache SRAM. Essa fase é limitada pela largura de banda de memória (memory-bandwidth-bound).
Tri Dao, criador do algoritmo FlashAttention e professor em Stanford, destacou a relevância de desenhar kernels de execução cientes da hierarquia de hardware:
"A maior parte do tempo de execução em Transformers modernos não é gasta em operações matemáticas puras, mas no tráfego constante de leitura e escrita entre a memória HBM lenta e o cache SRAM rápido do chip. Tornar o algoritmo de atenção consciente da entrada e saída de dados de baixo nível é o que viabiliza a escalabilidade prática das sequências longas."
Técnica de Engenharia
Mecanismo Central
Impacto Principal na Produção
Desafio de Implementação
Serving Nativo (Hugging Face)
Alocação contígua e estática de memória
Baseline funcional; alto desperdício de VRAM
Inviável para cargas corporativas de alta concorrência
PagedAttention (vLLM / SGLang)
Fragmentação virtual em páginas de blocos
Eleva o throughput de requisições de 2x a 4x
Complexidade de gerenciamento de metadados de tabelas
Quantização FP8 / FP4
Compressão de pesos e ativações para 8 e 4 bits
Reduz a pegada de VRAM pela metade e acelera o decode
Risco de degradação sutil de raciocínio lógico em benchmarks
Speculative Decoding
Modelo rascunho rápido valida tokens em lote
Acelera a geração de tokens por segundo em até 2,5x
Exige hospedar dois modelos na mesma máquina sem gargalo
Chunked Prefill
Fatiamento de prompts longos em pequenos lotes
Evita picos de TTFT em filas mistas de usuários
Calibração delicada do tamanho dos blocos de tokens
Até recentemente, rodar modelos com precisão reduzida significava usar quantização inteira como INT4 ou INT8. Embora funcionassem razoavelmente bem para modelos pequenos, a quantização inteira causava discrepâncias drásticas em tarefas complexas de raciocínio matemático e geração de código.
A virada de chave começou com o suporte a números em ponto flutuante de baixa precisão: o formato FP4.
Ao manter uma faixa dinâmica exponencial mesmo com apenas 4 bits por parâmetro, arquiteturas modernas conseguem compactar modelos de 70 bilhões de parâmetros — que antes exigiam duas placas H100 de 80 GB operando em paralelo — para rodar confortavelmente dentro de uma única GPU corporativa. O ganho não é apenas financeiro: ao reduzir pela metade o tráfego de dados necessário para carregar os pesos a cada ciclo de decodificação, a velocidade de geração de tokens por segundo praticamente dobra.
Menos placas, menos consumo elétrico e menos latência na ponta.
A Nova Fronteira dos Servidores Autônomos
A convergência entre algoritmos de paginação de memória, kernels customizados em Triton e quantização em ponto flutuante consolida uma transformação irreversível no desenvolvimento de software. A inferência de inteligência artificial deixou de ser privilégio restrito a quem paga faturas milionárias para três ou quatro provedores de nuvem centralizados.
O software aberto provou novamente que a engenharia de sistemas eficiente é capaz de extrair ordens de grandeza a mais de performance do silício existente.
Para os times que constroem produtos digitais em 2026, a mensagem é evidente: quem dominar as engrenagens de baixo nível do runtime de inferência terá a vantagem competitiva definitiva de custos, entregando respostas instantâneas enquanto a concorrência ainda espera o primeiro token sair da fila.
Desenvolvedor sênior e analista de tecnologia. Especialista em inteligência artificial, grandes modelos de linguagem (LLMs) e ecossistemas de desenvolvimento.
IA & Software
20:15
Guerra da Inferência: Como o vLLM e a Quantização FP4 Estão Derrubando o Custo dos LLMs